특허 검색에서 놓치는 문헌의 상당수는 기술이 달라서가 아니라 말이 달라서 놓칩니다. 같은 기술을 어떤 출원인은 "GPS"라 쓰고 어떤 출원인은 "GNSS"라 씁니다. 일본 공보는 "無人機", 중국 공보는 "无人机"입니다. 키워드 검색은 글자가 같은 문서만 찾으므로, 이 차이를 사람이 검색식에 하나씩 보태야 합니다.
벡터 DB 는 이 문제를 다른 방식으로 풉니다. 글자가 아니라 뜻으로 문서를 찾습니다.
벡터 DB 란
벡터 DB 는 문서를 숫자 묶음으로 바꿔 저장해 두는 데이터베이스입니다. 뜻이 비슷한 문서는 비슷한 숫자를 받습니다. 질문도 같은 방법으로 숫자로 바꾼 뒤, 숫자가 가장 비슷한 문서부터 돌려줍니다.[1]
이때 쓰는 용어가 둘 있습니다. 벡터는 숫자 여러 개를 한 묶음으로 적은 것입니다. 임베딩은 학습된 모델이 문장을 읽고 그 숫자 묶음을 매기는 일입니다.[2]
실제로는 숫자가 수백 개지만, 앞 네 개만 적은 예시 값으로 보면 이렇습니다.
| 문장 | 벡터 |
|---|---|
| 리튬 전지 음극에서 금속 가지가 자라는 것을 막는 분리막 | [0.21, -0.07, 0.65, 0.13, …] |
| 리튬 이차전지의 덴드라이트 성장 억제용 세퍼레이터 | [0.19, -0.05, 0.63, 0.15, …] |
| 드론의 실내 자율 비행 경로 생성 방법 | [-0.44, 0.52, -0.08, 0.37, …] |
앞의 두 문장은 겹치는 단어가 거의 없지만 숫자가 비슷합니다. 세 번째 문장은 숫자가 다릅니다. 벡터 DB 는 이 숫자의 차이로 문서를 고릅니다.
언어도 같습니다. 여러 언어를 함께 학습한 임베딩 모델은 같은 뜻의 문장에 언어와 무관하게 비슷한 숫자를 줍니다. 한국어 질문이 일본어 공보, 중국어 공보와 비슷한 숫자로 계산됩니다.
벡터 DB 의 동작: 저장할 때와 검색할 때 같은 임베딩 모델을 쓰고, 숫자가 가까운 것부터 돌려줍니다.
실제로 어떻게 찾아지나
2026년 10월, Claude 에 Findip 를 MCP 로 연결하고 아래 문장으로 검색했습니다.
검색어: 드론이 GPS 신호가 닿지 않는 실내에서 카메라 영상만으로 자기 위치를 파악하며 비행하는 방법
상위 결과 중 다섯 건입니다.
| 공보번호 | 국가 | 제목 | 원문에서 쓰인 표현 |
|---|---|---|---|
| KR1020170084966A | KR | 국소위치인식시스템 | "국소지역 위치 인식 시스템 즉 LPS", "건물 내의 환경에서는 GPS를 사용할 수 없다" |
| EP4745705A1 | EP | Autonomous flight method using visual navigation in event of GNSS anomaly | "GNSS signal is unavailable", "visual navigation", "optical flow" |
| JP7521761B2 | JP | 自己位置特定方法 | "GPS信号を用いることなく、ドローンの自己位置を特定" |
| CN115690610B | CN | 一种基于图像匹配的无人机导航方法 | "无GPS条件下自主导航", "图像匹配" |
| KR1025262020000B1 | KR | 실내 자율 비행 드론 제어 시스템 및 그 방법 | "GPS음영지역 또는 GPS수신이 어려운 상황에서도 자율 비행" |
검색어에 적은 단어는 "GPS", "카메라 영상", "자기 위치"입니다. 결과 문서에는 "GNSS", "optical flow", "自己位置特定", "图像匹配", "LPS", "GPS음영지역"이 적혀 있습니다. 검색어와 글자가 같은 문서는 다섯 건 중 하나도 없습니다. 뜻이 같아서 비슷한 숫자를 받았고, 그래서 함께 나왔습니다.
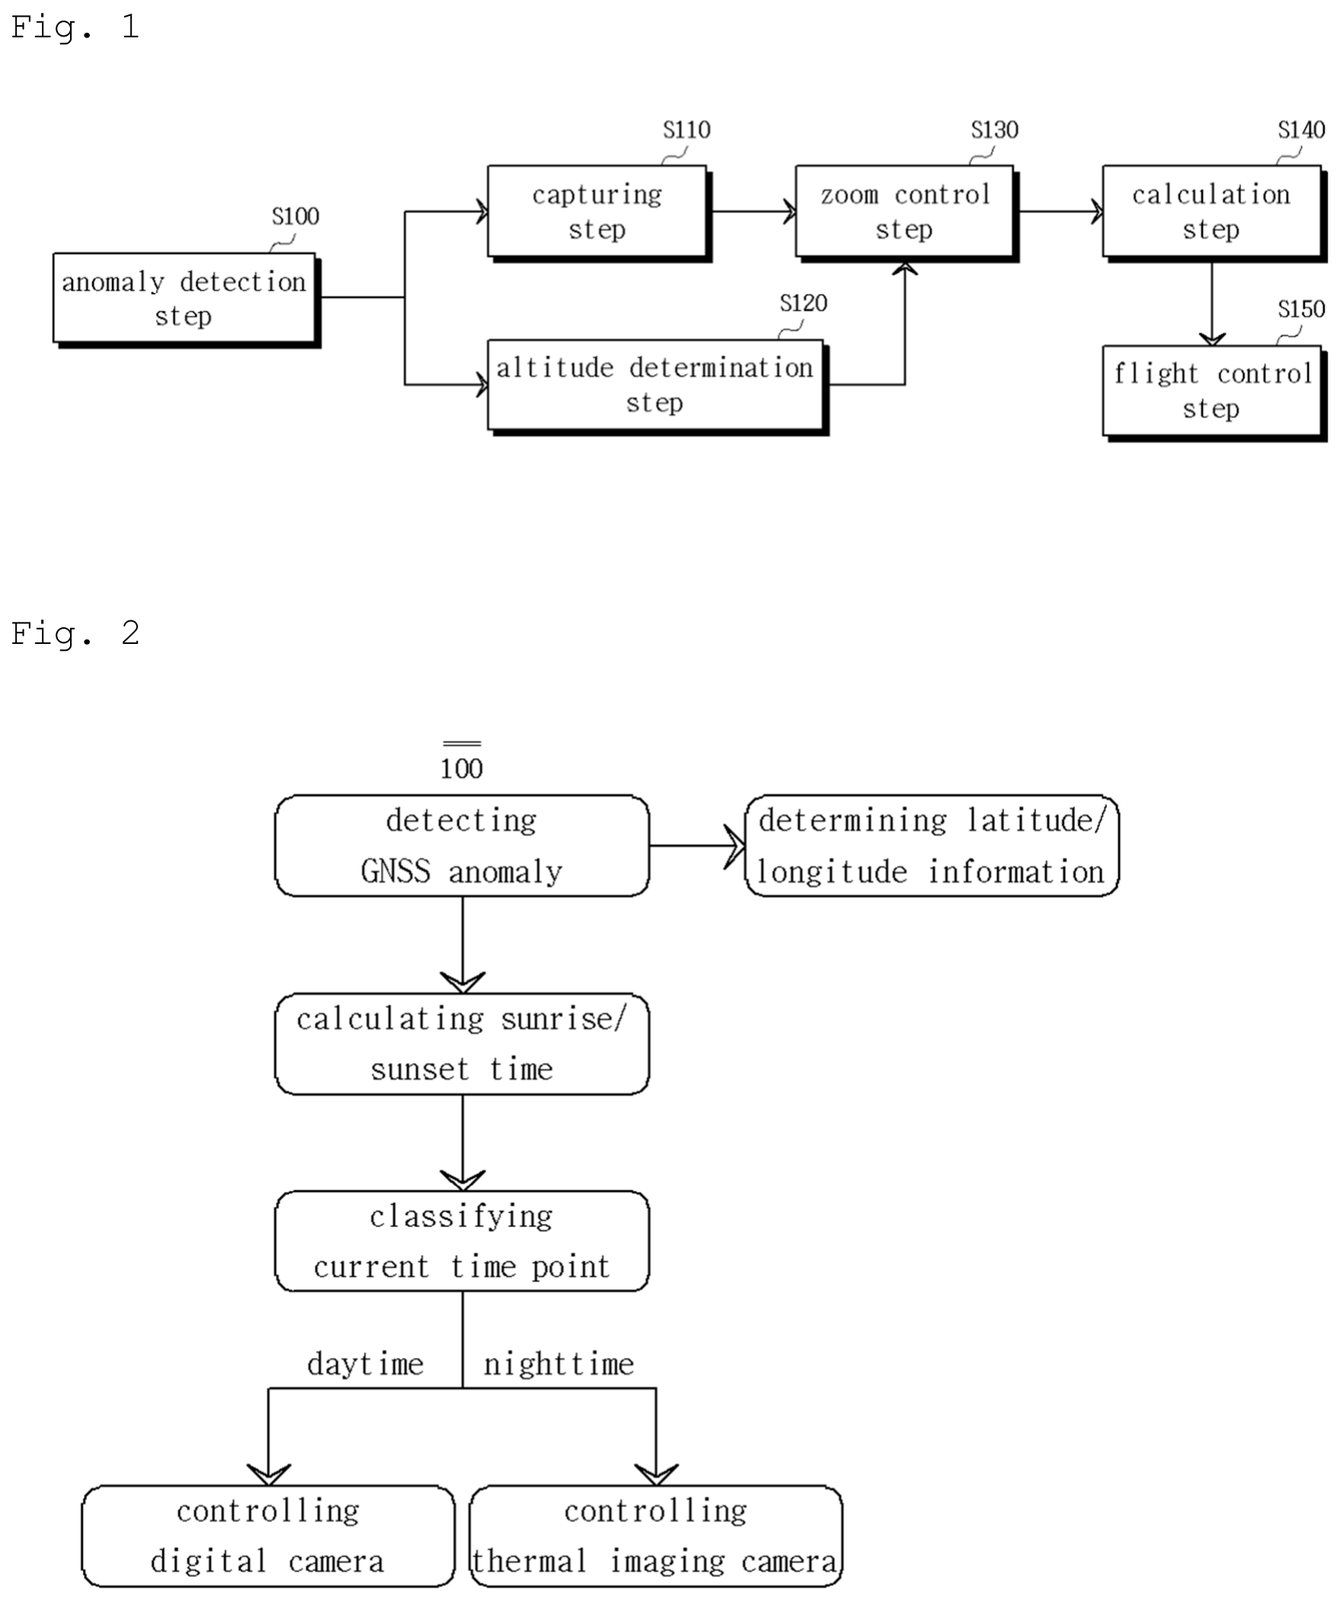
EP4745705A1 도 1·2 (Findip 에서 받은 도면). 검색어의 "GPS 신호가 닿지 않는", "카메라 영상"이 도면에서는 "GNSS anomaly", "capturing step"으로 적혀 있습니다.
키워드 검색보다 나은 점
키워드 검색은 같은 글자를, 벡터 검색은 비슷한 숫자를 찾습니다. 숫자는 설명용 예시 값입니다.
- 검색식을 만들지 않아도 됩니다. 키워드 검색은 동의어, 약어, 표기 변형을 사람이 미리 떠올려 OR 로 묶어야 합니다. 빠뜨린 단어 하나가 그대로 누락이 됩니다. 벡터 DB 는 뜻이 같으면 단어가 달라도 모읍니다. 위 검색에서 "GPS"만 적고도 "GNSS", "LPS", "GPS음영지역"이 나왔습니다.
- 번역하지 않아도 됩니다. 키워드 검색은 언어마다 검색식을 따로 만들어야 합니다. 벡터 DB 는 한 번의 질문으로 5개국 원문 공보를 한꺼번에 찾습니다. 위 검색에서 한국어 한 문장으로 영어, 일본어, 중국어 공보가 나왔습니다.
- 문장으로 물을 수 있습니다. "실내에서 카메라 영상만으로 자기 위치를 파악"처럼 문제와 수단을 적은 문장이 그대로 검색어가 됩니다. 발명 설명서나 제품 사양을 붙여 넣고 찾을 수 있습니다.
- 비슷한 순서로 나옵니다. 키워드 검색은 조건에 맞는 문서를 모두 돌려주고, 건수가 많으면 읽을 순서가 없습니다. 벡터 DB 는 질문과 가장 비슷한 문서부터 보여 주므로 위에서부터 읽으면 됩니다.
Findip 에서는 어떻게 쓰이나
Findip 는 한국·미국·일본·중국·유럽 5개국 공보를 제목, 초록, 청구항, 상세설명으로 나누어 각각 벡터로 만들어 저장합니다. 검색어도 같은 방식으로 벡터가 되고, 숫자가 가까운 조각부터 순서대로 찾습니다.[3]
이 검색은 별도의 검색창이 아니라 Claude 나 ChatGPT 같은 AI 안에서 실행됩니다. AI 에 Findip 를 연결해 두고 찾고자 하는 기술 내용을 넣은 뒤 "우선일 이전의 가까운 공보를 찾아 달라"고 요청하면 위 과정이 실행됩니다. AI 가 인용하는 공보번호는 모두 벡터 DB 에서 옵니다.[4]
FAQ
Q: 한국어로 검색하면 일본어·중국어 특허도 나오나요?
A: 네. 여러 언어를 함께 학습한 임베딩 모델은 같은 뜻의 문장에 언어와 무관하게 비슷한 숫자를 줍니다. 위 예시에서 한국어 한 문장으로 EP·JP·CN 공보가 함께 나왔습니다. 결과는 원문 언어로 나오므로, AI 에 요약이나 번역을 요청할 수 있습니다.
Q: 검색어는 어떻게 쓰는 것이 좋나요?
A: 단어를 나열하지 말고 문장으로 씁니다. 벡터 DB 는 문장의 뜻을 숫자로 바꾸므로, 어떤 문제를 어떤 방법으로 푸는지가 드러난 문장일수록 비슷한 문서가 모입니다. 위 예시의 검색어도 "실내에서", "카메라 영상만으로", "자기 위치를 파악"처럼 상황과 수단을 적은 한 문장입니다.
Q: 결과로 나온 공보의 원문은 어디서 보나요?
A: 결과마다 공보번호가 붙고, findip.ai/p/공보번호 주소에서 원문을 열 수 있습니다. 이 글의 결과 표에 있는 공보번호도 모두 그 주소로 연결되어 있습니다.
출처
- Pinecone, "What is a Vector Database & How Does it Work?" (pinecone.io/learn/vector-database). 벡터 DB 의 정의와 기존 DB 와의 차이.
- Milvus 공식 문서, "What is Milvus" (milvus.io/docs/overview.md). 임베딩이 비정형 데이터를 핵심 특징을 담은 숫자 벡터로 바꾼다는 설명.
- Findip 문서, 핵심 개념. 섹션별 임베딩과 벡터 검색.
- Findip 문서, 검증 가능한 실제 공보. 인용되는 공보번호가 모두 Findip DB 에서 온다는 점.