같은 과제라도 출원인마다 다른 말로 씁니다. 유압식 도어 클로저는 날이 추워지면 문이 느리게 닫힙니다. 이 문제를 한국 공보는 "계절이 변화함에 따라 발생되는 온도차에 의해 점도가 바뀌게 되고"라고 쓰고, 일본 공보는 "気温によってオイルの粘度が変化するため", 미국 공보는 "the viscosity of oil varies upon changing temperature"라고 씁니다. 청구항으로 가면 오일이 "유체"나 "緩衝剤(완충제)" 같은 상위개념으로 바뀌기도 합니다.
벡터 DB 란 무엇인가에서 시맨틱 검색은 문서를 숫자 묶음으로 바꾸고 질문과 숫자가 가까운 문서부터 찾는다고 설명했습니다. 이 숫자를 매기는 일이 임베딩입니다. 뜻이 같은 문장이 가까운 숫자를 받는 것은 임베딩 모델이 그렇게 되도록 학습되었기 때문입니다.
임베딩은 뜻의 지도에 좌표를 찍는 일입니다
임베딩 모델이 매기는 숫자 묶음은 지도 위의 좌표와 같습니다. 숫자가 두 개가 아니라 수백 개라는 점만 다릅니다. 검색은 질문이 찍힌 자리에서 가까운 공보를 찾는 일입니다. 이 지도는 모델이 대량의 글을 읽으며 그리므로, 어떻게 학습했는지에 따라 무엇이 가까이 놓일지가 정해집니다.
쓰이는 자리가 같은 말은 가까이 놓입니다
언어학에는 비슷한 맥락에 쓰이는 말은 뜻도 비슷하다는 생각이 있습니다. 분포 가설이라고 부릅니다.[1] 2013년에 발표된 word2vec 은 이 생각을 대량의 글에 적용했습니다. 앞뒤 단어로 가운데 단어를, 또는 가운데 단어로 앞뒤 단어를 맞히도록 학습시키는 것만으로 뜻이 비슷한 단어가 가까운 숫자를 받았습니다.[2]
특허 문헌에서 "작동유", "오일", "유체", "緩衝剤"는 모두 "점도", "피스톤", "유로", "닫힘 속도"와 함께 나옵니다. 함께 나오는 말이 같으므로 지도에서 가까이 놓입니다. 동의어와 상위개념이 검색식 없이 묶이는 이유입니다.
짝을 이루는 문장은 당기고, 관계없는 문장은 밀어냅니다
문장 임베딩 모델은 짝을 이루는 문장 쌍을 보고 학습합니다.[3] 요즘 모델은 짝은 가까이, 같은 묶음 안의 다른 문장은 멀리 놓이도록 학습합니다.[4] E5 는 질문과 답, 논문 제목과 초록, 웹 문서 제목과 본문 같은 쌍을 대량으로 모아 학습했습니다.[4] 길이와 표현이 다른 두 글을 짝으로 배우므로, 한 문장짜리 질문이 긴 배경기술 문단 가까이에 놓일 수 있습니다.
서로 번역인 문장은 같은 자리에 놓입니다
여러 언어를 다루는 임베딩 모델은 대개 번역 쌍으로 학습합니다. 한 연구는 학습 원리를 "번역된 문장은 원문과 같은 위치에 놓여야 한다"로 설명합니다.[5] LaBSE 는 번역 문장 쌍을 써서 109개 이상 언어의 문장을 한 지도에 놓았습니다.[6] 한국어 질문이 일본어나 영어 공보와 가까이 놓이는 것은 이 때문입니다. Findip 에서도 질문 언어가 결과 언어를 정하지 않습니다. 한국어로 물어도 영어로 물어도 한국·미국·일본·중국·유럽 공보를 함께 찾습니다.[7]
임베딩 모델이 뜻의 지도를 그리는 세 가지 방식. 오른쪽 점의 위치는 설명용 배치입니다.
네 가지 말로 같은 기술을 물었습니다
2026년 10월 20일, Claude 에 Findip 를 MCP 로 연결하고 같은 기술을 네 가지로 써서 검색했습니다. 질의마다 상위 10건을 받았습니다.
| 검색어 | 쓴 말 | |
|---|---|---|
| Q1 | 도어 클로저 작동유 점도 변화에 대한 온도 보상 | 한국어 전문 용어 |
| Q2 | 계절이 바뀌어 기온이 달라져도 문이 닫히는 속도가 일정하게 유지되는 도어 클로저 | 한국어 일상어 |
| Q3 | 温度によって作動油の粘度が変わってもドアの閉まる速さが変わらないドアクローザ | 일본어 |
| Q4 | door closer that keeps the same closing speed in cold winter and hot summer | 영어 |
같은 과제를 다룬 공보 중 여섯 건입니다.
| 공보번호 | 국가 | 원문에서 과제를 쓴 표현 | 찾은 질의 |
|---|---|---|---|
| KR1020250120005A | KR | "계절이 변화함에 따라 발생되는 온도차에 의해 점도가 바뀌게 되고" | Q1, Q2, Q3 |
| US09556659B2 | US | "the viscosity of oil varies upon changing temperature" | Q2, Q3, Q4 |
| JP2013155495A | JP | "気温によってオイルの粘度が変化するため" | Q2 |
| JP2008196256A | JP | "環境温度変化に対するドアの閉じ時間の変化を低減" | Q3 (같은 패밀리의 KR1020090110912A는 Q1) |
| JP5260823B2 | JP | "寒冷時の温度の低い雰囲気では作動油の粘度が高くなり" | Q3 |
| CN1952091B | CN | "门的开关速度不随季节而变化" | Q3 |
결과는 이렇게 읽습니다.
- 동의어. Q2 에는 "점도", "작동유", "온도"가 없습니다. 그래도 점도 변화를 과제로 적은 한국·일본·미국 공보가 나왔습니다.
- 상위개념. JP2008196256A 의 청구항 1 은 오일을 "緩衝剤"라고 쓰고, 청구항 2 에서 "シリコーンオイル"로 좁힙니다. KR1020250120005A 의 청구항 1 도 "유체"라고 씁니다. 검색어는 "작동유"였지만 상위개념으로 쓴 청구항이 걸렸습니다.
- 다른 언어. 일본어 질의(Q3)로 한국·미국·중국 공보가, 한국어 질의(Q2)로 일본·미국·유럽 공보가 나왔습니다. KR1020250120005A 는 한국어 두 질의와 일본어 질의에서 모두 나왔습니다.
- 질의마다 다른 공보. CN1952091B 는 Q3 에서만, JP2013155495A 는 Q2 에서만 나왔습니다. 표현과 언어를 바꿔 여러 번 물으면 서로 다른 공보가 더해집니다.
이번 검색을 뜻의 지도로 옮긴 그림. 설명용 배치이며 실제 좌표가 아닙니다.
기능으로 물으면 구조가 다른 공보가 모입니다
네 질의 모두 해결 수단을 적지 않았습니다. "기온이 바뀌어도 닫히는 속도가 같다"는 기능만 적었습니다. 그런데 찾아진 공보는 같은 과제를 서로 다른 구조로 풉니다.
- KR1020250120005A: 온도에 따라 늘어나고 줄어드는 형상기억합금 스프링이 유로를 지나는 유체 양을 조절합니다(청구항 2).
- JP2008196256A: 점도가 온도에 따라 적게 변하는 완충제, 예컨대 실리콘 오일을 씁니다(청구항 1, 2).
- JP5260823B2, CN1952091B: 점도지수가 높은 작동유 조성물로 풉니다.
- EP4502753B1: 온도에 따라 변형되는 밸브 부재가 유로 단면적을 바꿉니다.
- US09556659B2: 오일 대신 공기를 씁니다. 공기 흐름은 기온에 민감하지 않다는 것이 근거입니다.
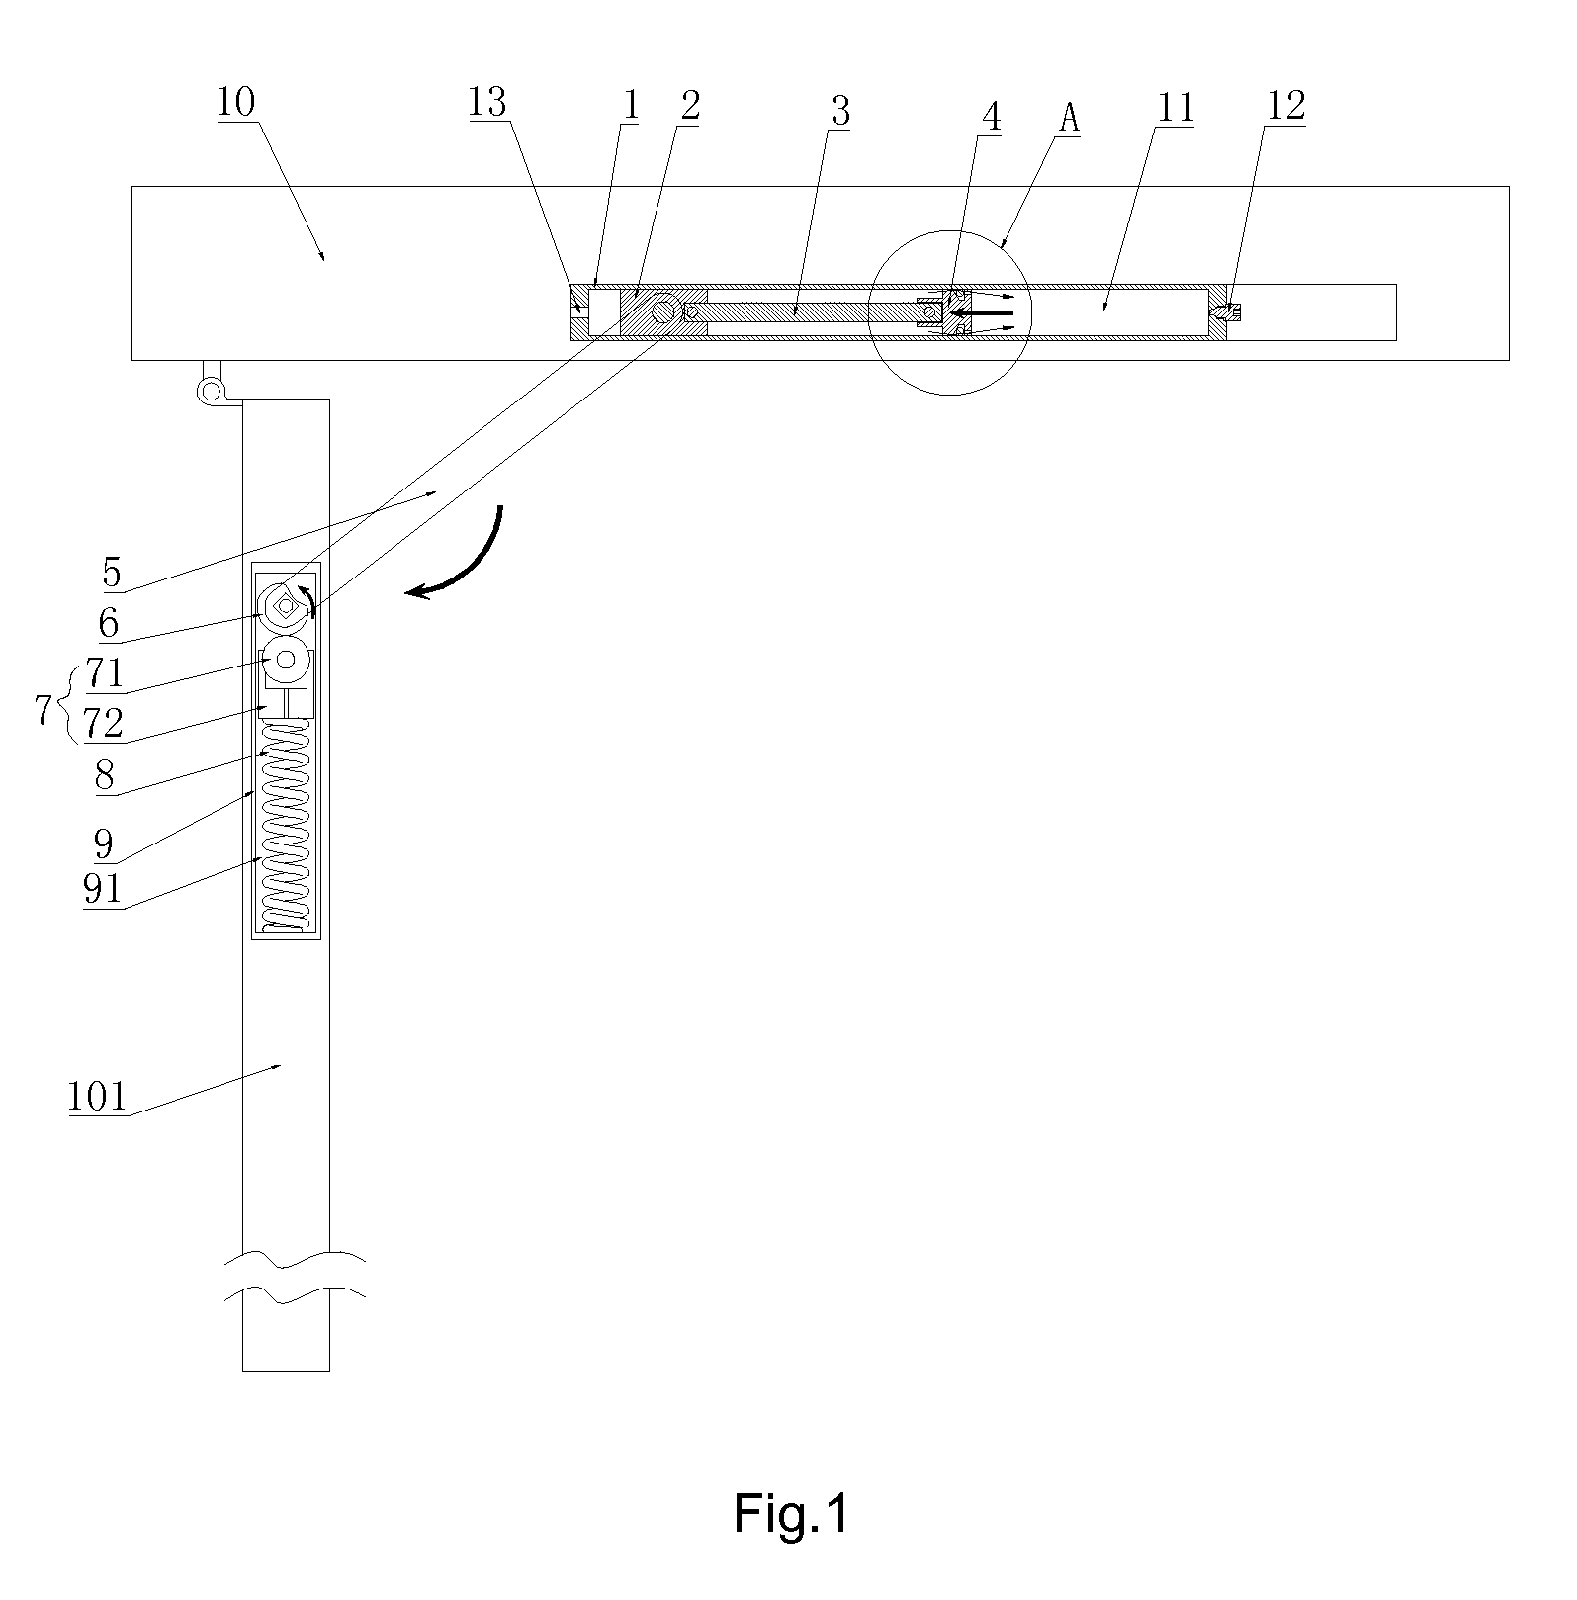
US09556659B2 Fig. 1 (Findip 에서 받은 도면). 문틀(10) 안 실린더(1)의 공기를 조절 밸브(12)로 빼며 닫힘 속도를 조절합니다.
수단은 달라도 배경기술에 과제를 적은 문장이 비슷하므로, 과제를 적은 질문 가까이에 함께 모였습니다. 형상기억합금, 실리콘 오일, 공기 실린더를 미리 떠올리지 않아도 됩니다.
반대로 구조만 적으면 다른 분야로 갑니다. 아래 질의는 KR1020250120005A 의 구조를 풀어 쓴 것입니다.
검색어: 형상기억합금 스프링이 온도에 따라 늘어나고 줄어들면서 도어 클로저 안의 오일 통로를 넓히거나 좁히는 구조
상위 5건은 내연기관 피스톤 냉각 장치(JP5190428B2), 피스톤 구조(JP2020143629A), 형상기억 코일 스프링 제조방법(KR1011836500000B1), 형상기억 스프링을 쓴 자동 주사 장치(CN113677383A) 등이었습니다. KR1020250120005A 는 상위 5건에 없었습니다. 문장의 대부분이 형상기억합금, 스프링, 오일 통로 같은 수단의 말이어서, 지도에서 "온도로 움직이는 밸브와 스프링" 쪽에 찍혔습니다. 같은 수단이 다른 분야에서 쓰인 예를 볼 때는 이 성질이 쓸모가 있습니다. 대상 분야를 벗어나지 않으려면 용도와 과제를 문장에 함께 적습니다.
특허 문서가 이 방식에 맞는 이유
같은 기술을 일부러 넓은 말로 씁니다. WIPO 의 특허 명세서 작성 매뉴얼은 실시예에 쓴 용어보다 덜 쓰이더라도 더 넓은 용어를 찾아 청구항을 쓰라고 권합니다. 못, 나사, 리벳을 나열하는 대신 "체결구"나 "체결 수단"이라고 쓰면 더 넓게 정의된다는 예도 듭니다.[8] 미국 심사 기준은 출원인이 명세서에서 용어를 스스로 정의할 수 있다고 봅니다.[9] 그래서 같은 기술이 출원인마다 다른 말로 적히고, 위 예시에서도 오일이 청구항에서 "유체", "緩衝剤"가 되었습니다. 글자를 맞추는 검색에서는 이 차이를 사람이 검색식으로 메워야 합니다. 임베딩은 쓰임새가 같은 말을 가까이 놓으므로 이 차이를 상당 부분 흡수합니다.
과제와 해결과 효과를 문장으로 씁니다. PCT 규칙은 기술 과제와 그 해결을 이해할 수 있도록 발명을 적고, 유리한 효과가 있으면 종래기술과 견주어 적게 합니다.[10] 그래서 공보에는 대개 무엇이 문제였고 어떻게 풀었는지를 설명하는 문장이 있습니다. 이번 검색에서 질문과 가장 가깝게 맞닿은 곳도 대부분 그런 문단이었습니다. KR1020250120005A 는 배경기술 [0002]~[0007], US09556659B2 는 BACKGROUND [0003], JP2013155495A 는 背景技術 [0002]~[0005] 문단입니다. 과제를 적은 질문이 과제를 적은 문단을 찾았습니다.
구조가 정해져 있습니다. 같은 PCT 규칙은 명세서를 기술분야, 배경기술, 발명의 개시, 도면의 간단한 설명, 발명을 실시하기 위한 형태, 산업상 이용가능성 순으로 쓰는 것을 원칙으로 하고,[10] 청구항과 요약은 따로 둡니다. 성격이 다른 내용이 정해진 자리에 나뉘어 있어, 공보를 뜻이 한데 모인 단위로 자르기 쉽습니다. Findip 는 공보를 제목, 초록, 청구항, 상세설명으로 나누고, 문단과 청구항 단위로 벡터를 만듭니다.[11] 문단 단위 검색은 다음 글에서 따로 설명합니다.
같은 발명이 여러 언어로 남습니다. 한 발명을 여러 나라에 출원하면 같은 내용이 여러 언어의 공보로 공개됩니다. 위 예시의 JP2008196256A 와 KR1020090110912A 는 같은 패밀리이고, 일본어 질의는 일본 공보를, 한국어 질의는 한국 공보를 찾았습니다. 번역 쌍을 같은 자리에 놓도록 배운 모델에서는 어느 언어로 물어도 같은 발명 가까이에 닿습니다.
한계
긴 글 하나를 한 좌표로 찍으면 뜻이 흐려집니다
좌표 하나에 담을 수 있는 뜻에는 한계가 있습니다. 정해진 길이의 벡터 하나로는 문서가 길수록 정확히 찾아내기 어려워진다는 분석이 있습니다.[12] 널리 쓰이는 문장 임베딩 라이브러리의 문서도 입력이 모델의 최대 길이를 넘으면 뒷부분을 잘라 내며, BERT 계열 모델에서 그 길이는 흔히 512 토큰, 영어로 300~400 단어 정도라고 설명합니다.[13] 이 글에서 본 US09556659B2 의 상세설명만 해도 이보다 깁니다. 공보 전체를 점 하나로 찍으면 여러 과제와 실시예가 한 점에 섞이고, 뒷부분은 반영되지 않을 수 있습니다. Findip 가 공보를 문단과 청구항 단위로 나눠 넣는 것도 이 한계를 피하기 위해서입니다.
숫자와 고유 명칭에 약합니다
검색어 1: 점도지수 260 이상인 도어 클로저용 작동유
검색어 2: 점도지수 100 이하인 도어 클로저용 작동유
두 질의의 상위 5건 중 세 건(KR1020150127623A, KR1002797300000B1, JP3027828A)이 같았습니다. 점도지수 260 이상의 도어 클로저용 작동유를 다룬 JP5260823B2 는 어느 쪽에도 없었습니다. "260 이상"과 "100 이하"의 차이가 지도에서는 거의 거리를 만들지 못했습니다.
연구 결과도 같은 방향입니다. 단어를 조각내 읽는 BERT 계열 모델은 숫자의 크기를 덜 정확하게 담았습니다.[14] 사람·장소처럼 드문 이름이 든 질문에서도 벡터 검색은 글자를 맞추는 방식보다 크게 뒤졌고, 널리 알려진 이름에서만 잘 일반화했습니다.[15] 부품번호나 모델명 같은 드문 고유 명칭도 같은 약점을 보일 수 있습니다. 수치 범위와 형번은 뜻을 설명하는 데 쓰고, 맞는지는 결과 공보의 원문에서 확인합니다.
부정과 제외 조건은 잘 반영되지 않습니다
검색어: 작동유를 쓰지 않아 기온이 바뀌어도 닫히는 속도가 변하지 않는 도어 클로저
상위 5건 중 KR2002284490000Y1과 KR1020090110912A는 내부에 오일을 채운 구조입니다. 오일 대신 공기를 쓰는 US09556659B2 는 상위 5건에 없었습니다. "쓰지 않아"가 붙어도 나머지 말이 같으면 지도에서 같은 자리에 찍히기 때문입니다.
부정 표현 하나만 다른 두 문서를 구분하는 연구 시험에서도 대부분의 검색 모델은 무작위로 고르는 것과 같거나 그보다 못했고, 벡터 검색이 쓰는 방식은 그중 낮은 쪽에 속했습니다.[16] "~을 포함하지 않는" 같은 조건은 결과 공보의 원문에서 확인해야 합니다.
짧은 용어 나열은 흔한 뜻으로 끌려갑니다
전문 용어로 쓴 Q1 의 상위 10건 중 도어 클로저 공보는 세 건이었습니다. 나머지는 광디스크 기록(CN101206886B), 카메라 초점 제어(JP2019061126A), 연료 분사기 액추에이터(CN102144083A)처럼 다른 분야에서 온도에 따라 보정하거나 제어하는 공보였습니다. "온도 보상"은 여러 분야에서 흔히 쓰는 말이라 이 말이 문장의 무게를 차지했습니다. 상황을 문장으로 풀어 쓴 Q2 는 10건 중 9건이 도어 클로저 관련 공보였습니다. 자연어 검색 방법에서 키워드 나열보다 문장을 권하는 이유입니다.
FAQ
Q: 동의어와 상위개념을 검색어에 모두 적어야 하나요?
A: 적지 않아도 됩니다. 위 예시에서 "작동유", "作動油"로 물었는데 청구항에 "유체", "緩衝剤"로 쓴 공보가 나왔습니다. 다만 질의마다 나오는 공보가 조금씩 다르므로, 표현을 바꿔 두세 번 묻고 결과를 모아 보면 누락이 줄어듭니다.
Q: 어느 언어로 묻는 것이 좋나요?
A: 익숙한 언어로 물으면 됩니다. 한국어로 물어도 일본·미국·유럽 공보가 나왔습니다. 다만 언어마다 결과가 조금씩 달라서, 다른 언어로 한 번 더 물으면 다른 공보가 더해질 수 있습니다.
Q: 수치 범위나 부품번호로 검색해도 되나요?
A: 숫자와 형번만으로는 잘 찾아지지 않습니다. 그 수치나 부품이 무슨 역할을 하는지를 문장으로 적어 검색하고, 수치가 맞는지는 결과 공보의 청구항과 상세설명에서 확인합니다.
Q: "~을 포함하지 않는" 조건은 어떻게 검색하나요?
A: 검색어에 넣어도 결과에 잘 반영되지 않습니다. 기술 내용은 긍정문으로 묻고, 조건은 결과 공보의 원문에서 확인합니다. AI 에 결과 공보의 원문을 읽고 조건에 맞는지 표로 정리해 달라고 요청할 수 있습니다.
출처
- Z. S. Harris, "Distributional Structure", Word 10(2–3), 146–162, 1954 (doi.org/10.1080/00437956.1954.11659520). J. R. Firth, "A synopsis of linguistic theory 1930–1955", Studies in Linguistic Analysis, 1957. 비슷한 맥락에 쓰이는 말은 뜻도 비슷하다는 분포 가설.
- T. Mikolov 외, "Efficient Estimation of Word Representations in Vector Space", 2013 (arxiv.org/abs/1301.3781). 대량의 글에서 단어 벡터를 학습해 뜻이 비슷한 단어를 찾은 연구.
- N. Reimers, I. Gurevych, "Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks", EMNLP 2019 (arxiv.org/abs/1908.10084). 문장 쌍으로 학습해 서로 비교할 수 있게 만든 문장 벡터.
- L. Wang 외, "Text Embeddings by Weakly-Supervised Contrastive Pre-training", 2022 (arxiv.org/abs/2212.03533). E5 의 학습 데이터 CCPairs 를 이루는 문장 쌍의 종류.
- N. Reimers, I. Gurevych, "Making Monolingual Sentence Embeddings Multilingual using Knowledge Distillation", EMNLP 2020 (arxiv.org/abs/2004.09813). 번역된 문장을 원문과 같은 위치에 놓는 학습.
- F. Feng 외, "Language-agnostic BERT Sentence Embedding", ACL 2022 (arxiv.org/abs/2007.01852). 번역 쌍으로 학습한 109개 이상 언어의 문장 임베딩.
- Findip 문서, 다국어 검색. 질문 언어와 결과 언어의 분리.
- WIPO, WIPO Patent Drafting Manual, 2판, 2023, 52쪽·72쪽 (wipo.int/edocs/pubdocs/en/wipo-pub-867-23-en-wipo-patent-drafting-manual.pdf). 청구항에 넓은 용어와 기능적 용어를 쓰는 방법.
- USPTO, Manual of Patent Examining Procedure 2111.01 IV (uspto.gov/web/offices/pac/mpep/s2111.html). 출원인이 용어를 스스로 정의할 수 있다는 기준.
- WIPO, PCT 규칙 5.1 (wipo.int/pct/en/texts/rules/r5.html). 명세서의 기재 순서와 기술 과제·해결·효과의 기재.
- Findip 문서, 핵심 개념. 섹션별 분할과 문단·청구항 단위의 벡터 검색.
- Y. Luan 외, "Sparse, Dense, and Attentional Representations for Text Retrieval", TACL 9, 2021 (arxiv.org/abs/2005.00181). 고정 길이 벡터로 긴 문서를 정확히 찾는 데 따르는 한계.
- Sentence Transformers 공식 문서, "Computing Embeddings" 중 Input Sequence Length (sbert.net/examples/sentence_transformer/applications/computing-embeddings/README.html). 최대 길이를 넘는 입력의 잘림.
- E. Wallace 외, "Do NLP Models Know Numbers? Probing Numeracy in Embeddings", EMNLP 2019 (arxiv.org/abs/1909.07940). 임베딩에 담긴 수의 크기 정보.
- C. Sciavolino 외, "Simple Entity-Centric Questions Challenge Dense Retrievers", EMNLP 2021 (arxiv.org/abs/2109.08535). 드문 고유 명칭에서 벡터 검색이 약한 현상.
- O. Weller, D. Lawrie, B. Van Durme, "NevIR: Negation in Neural Information Retrieval", EACL 2024 (arxiv.org/abs/2305.07614). 부정 표현만 다른 문서 쌍에 대한 검색 모델 평가.